
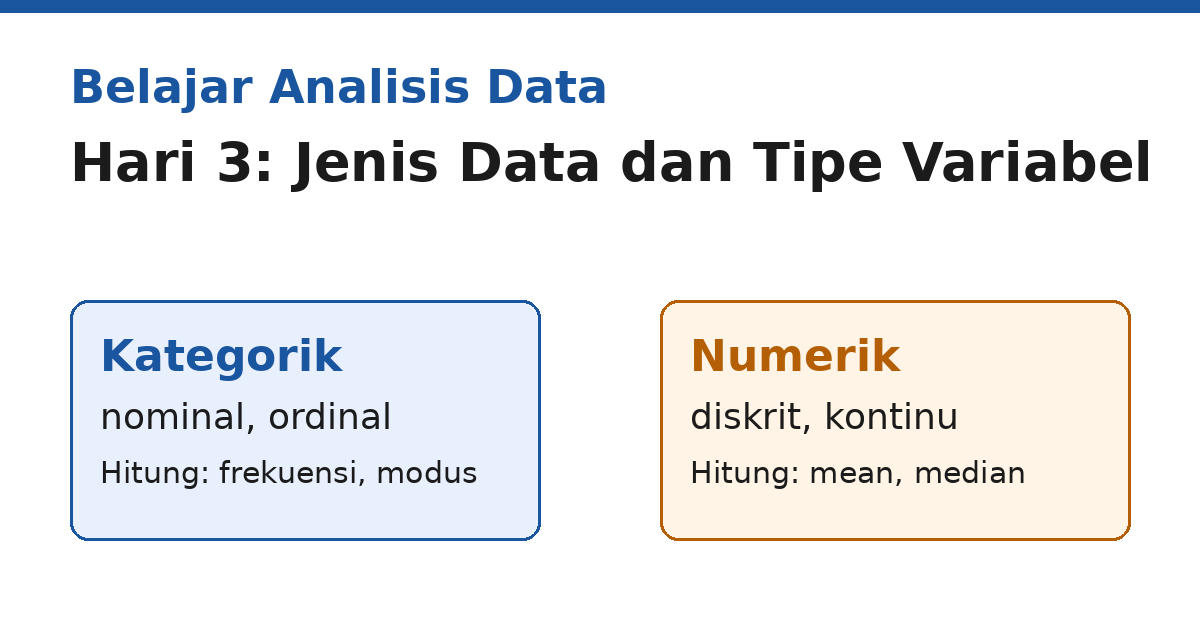
Sebelum menghitung apa pun, analis perlu tahu jenis data yang sedang dipegang, karena jenis data menentukan operasi apa yang masuk akal. Rata-rata kode pos tidak punya makna, sedangkan rata-rata berat badan punya makna. Catatan hari ketiga ini membahas cara membedakan tipe variabel dan menuliskannya di SQL, pandas, dan R.
Tujuan belajar
- Membedakan data kategorik dan numerik, serta empat skala pengukuran menurut Stevens (1946).
- Memilih statistik yang sesuai untuk setiap tipe variabel.
- Menuliskan tipe variabel dengan benar di SQL, pandas, dan R.
Konsep inti
Saat pertama mencoba analisis, saya mengira kolom yang berisi angka otomatis bisa dirata-ratakan. Ternyata nomor rekam medis dan kode pos juga tersimpan sebagai angka, tetapi fungsinya hanya sebagai label. Kesalahan ini kelihatan sepele, tetapi hasil statistik yang dihasilkannya bisa menyesatkan.

Stevens (1946) memperkenalkan empat skala pengukuran. Urutannya dari yang paling sederhana sampai yang paling kaya operasi matematikanya adalah sebagai berikut.
- Nominal: kategori tanpa urutan, misalnya golongan darah atau nama kota. Yang bisa dilakukan: menghitung frekuensi dan modus.
- Ordinal: kategori dengan urutan, tetapi jarak antarurutan tidak diketahui sama, misalnya tingkat pendidikan (SD, SMP, SMA, sarjana). Yang bisa dilakukan: median dan persentil.
- Interval: angka dengan jarak yang sama, tetapi tanpa nol mutlak, misalnya suhu dalam Celsius. Yang bisa dilakukan: selisih dan rata-rata.
- Rasio: angka dengan jarak yang sama dan nol mutlak, misalnya berat badan, lama rawat inap, atau jumlah anak. Yang bisa dilakukan: semua operasi di atas, termasuk perbandingan dua kali lipat.
Kategorik, numerik, diskrit, dan kontinu
Dua pembagian ini sering dipakai bersama, tetapi menjawab pertanyaan yang berbeda. Skala Stevens menjawab operasi apa yang boleh dilakukan pada sebuah variabel. Pembagian diskrit dan kontinu menjawab dari mana nilainya datang. Nilai diskrit dihitung, misalnya jumlah kunjungan (0, 1, 2, dan seterusnya). Nilai kontinu diukur dan bisa berada di antara dua bilangan, misalnya tinggi badan 165,2 cm. Gambar pohon di atas sengaja disederhanakan: interval dan rasio keduanya numerik, dan diskrit-kontinu adalah pembagian lain di dalam kelompok numerik.
Dari definisi ke kode
Contoh berikut memakai dataset penguins, yang tersedia sebagai dataset bawaan di seaborn dan paket palmerpenguins di R. Dataset ini berisi pengukuran penguin di Kepulauan Palmer, Antartika, bukan data manusia. Kolom species dan island adalah nominal, sedangkan body_mass_g adalah rasio dan kontinu. Versi SQL menghitung jumlah dan rata-rata massa per kelas massa. Versi pandas dan R menunjukkan cara menyatakan tipe variabel.
-- SQL (PostgreSQL): kelas massa ordinal dibuat dari variabel numerik
-- Ambang 3500 dan 4500 hanya contoh untuk latihan
SELECT
  species,                                  -- kategorik nominal
  CASE
    WHEN body_mass_g < 3500 THEN '1 ringan'
    WHEN body_mass_g < 4500 THEN '2 sedang'
    ELSE '3 berat'                          -- awalan angka menjaga urutan
  END AS kelas_massa,                       -- kategorik ordinal hasil dari numerik
  COUNT(*) AS jumlah,
  AVG(body_mass_g) AS rata_rata_massa       -- rata-rata hanya masuk akal untuk rasio
FROM penguins
WHERE body_mass_g IS NOT NULL
GROUP BY 1, 2
ORDER BY 1, 2;
# Python (pandas)
import seaborn as sns
import pandas as pd
# Dataset bawaan seaborn; sumber asli: Horst, Hill, & Gorman (2020)
penguins = sns.load_dataset("penguins")
# Periksa tipe setiap kolom
print(penguins.dtypes)
# species: nominal, cukup tipe category tanpa urutan
penguins["species"] = penguins["species"].astype("category")
# Ordinal perlu urutan eksplisit agar 'ringan' < 'sedang' < 'berat'
ukuran = pd.Categorical(["sedang", "ringan", "berat"],
categories=["ringan", "sedang", "berat"],
ordered=True)
print(ukuran.min()) # 'ringan', karena urutannya sudah ditetapkan
# body_mass_g: rasio, sehingga describe() dan rata-rata masuk akal
print(penguins["body_mass_g"].describe())# R (tidyverse)
library(tidyverse)
library(palmerpenguins) # dataset penguins, Horst, Hill, & Gorman (2020)
# Nominal: hitung frekuensi per species
penguins |>
count(species)
# Ordinal: di R disimpan sebagai factor dengan urutan eksplisit
ukuran <- factor(c("sedang", "ringan", "berat"),
levels = c("ringan", "sedang", "berat"),
ordered = TRUE)
ukuran[1] > ukuran[2] # TRUE: 'sedang' lebih tinggi daripada 'ringan'
# Rasio: rata-rata dan selisih masuk akal
penguins |>
summarise(rata_massa = mean(body_mass_g, na.rm = TRUE))Contoh kecil
Contoh kecil. Sebuah klinik ingin melaporkan kepuasan layanan dengan skor 1 sampai 5, dari sangat tidak puas sampai sangat puas. Skor ini terlihat seperti angka, tetapi jarak antara 1 dan 2 belum tentu sama dengan jarak antara 4 dan 5. Saya memperlakukannya sebagai ordinal: laporan memakai median dan distribusi frekuensi, bukan rata-rata. Jika tim tetap ingin rata-rata, asumsi itu harus ditulis di laporan.
Kesalahan yang sering terjadi
Waspadai empat hal ini:
- Menghitung rata-rata kolom kode pos, ID pelanggan, atau nomor urut. Kolom ini nominal meskipun berisi angka.
- Menyimpan kategori sebagai angka 1, 2, 3 tanpa kamus data, lalu lupa arti setiap kodenya.
- Menganggap skala Likert 1 sampai 5 sebagai interval tanpa menuliskannya sebagai asumsi.
- Mengubah variabel kontinu menjadi kategori tanpa alasan yang jelas, sehingga informasi ikut hilang.
Latihan
- Tentukan skala Stevens untuk nomor rekam medis, lama rawat inap dalam hari, dan tingkat pendidikan (SD, SMP, SMA, sarjana).
- Suhu ruangan dapat dinyatakan dalam Celsius atau Kelvin. Mana yang termasuk rasio, dan mengapa?
Kunci jawaban singkat: (1) Nomor rekam medis adalah nominal, karena hanya label identitas. Lama rawat inap adalah rasio dan diskrit, karena dihitung dalam hari dan nol berarti tidak ada rawat inap. Tingkat pendidikan adalah ordinal, karena ada urutan tetapi jarak antarjenjang tidak diukur. (2) Kelvin adalah rasio, karena nol Kelvin adalah nol mutlak. Celsius adalah interval, karena nol Celsius hanya titik acuan air membeku dan tidak berarti tanpa suhu.
Ringkasan
Tipe variabel menentukan statistik yang boleh dihitung, jadi pertanyaan tentang jenis data sebaiknya dijawab sebelum query pertama dijalankan. Besok kita membahas statistik deskriptif, yaitu mean, median, dan modus, yang hanya bermakna setelah tipe variabel jelas.
Sumber bacaan
Horst, A. M., Hill, A. P., & Gorman, K. B. (2020). palmerpenguins: Palmer Archipelago (Antarctica) penguin data. https://doi.org/10.5281/zenodo.3960218
pandas documentation. “Categorical data”. https://pandas.pydata.org/docs/user_guide/categorical.html
Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680.
Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for Data Science (2nd ed.). O’Reilly Media. https://r4ds.hadley.nz/
Navigasi seri Belajar Analisis Data
- Berikutnya: Hari 4, Statistik Deskriptif: Mean, Median, Modus (terbit 14 November 2026 pukul 09.00 WIB)
- Sebelumnya: Hari 2, Merumuskan Pertanyaan Bisnis dan Metrik
- Semua tulisan seri Belajar Analisis Data
Tinggalkan Balasan