
Ringkasan: Statistik deskriptif merangkum data menjadi beberapa angka yang mudah dibaca, dan ukuran pusat adalah yang paling sering dihitung lebih dulu. Mean, median, dan modus masing-masing menjawab pertanyaan “nilai yang khas itu yang mana?” dengan cara berbeda, dan pilihan di antaranya bergantung pada bentuk datanya.
Tujuan belajar
- Menghitung mean, median, dan modus dari satu kumpulan data.
- Menjelaskan mengapa mean mudah terpengaruh nilai ekstrem, sedangkan median tidak.
- Memilih ukuran pusat yang sesuai dengan tipe dan bentuk data.
Konsep inti
Saat pertama kali menghitung rata-rata nilai transaksi dari sebuah tabel latihan, saya tidak memeriksa sebarannya dulu. Hasilnya terasa aneh, karena angka rata-ratanya tidak mirip dengan hampir semua transaksi di tabel itu. Ternyata ada satu transaksi yang jauh lebih besar dari yang lain. Dari kejadian kecil itu saya belajar bahwa ukuran pusat selalu perlu dibaca bersama bentuk datanya.
Mean adalah jumlah seluruh nilai dibagi banyaknya nilai. Istilah “rata-rata” atau “average” dalam percakapan sehari-hari biasanya merujuk pada mean (OpenStax, n.d.). Mean memakai setiap nilai dalam perhitungannya, sehingga satu nilai ekstrem ikut menggeser hasilnya.
Median adalah nilai tengah setelah data diurutkan. Jika jumlah data genap, median adalah rata-rata dua nilai di tengah. Median hanya bergantung pada posisi data, bukan pada besar setiap nilainya, sehingga lebih tahan terhadap nilai ekstrem (MathWorks, n.d.; PTC, n.d.).
Modus adalah nilai yang paling sering muncul. Sebuah data bisa punya lebih dari satu modus jika beberapa nilai sama-sama paling sering muncul, dan bisa juga tidak punya modus sama sekali jika semua nilai unik (OpenStax, n.d.). Modus satu-satunya ukuran pusat yang bisa dipakai untuk data kategorik, misalnya kota asal pelanggan.
NIST juga memperkenalkan mean terpangkas (trimmed mean), yaitu mean setelah membuang sebagian kecil nilai terendah dan tertinggi, misalnya 5 persen di setiap ujung. Ukuran ini mencoba menyeimbangkan kepekaan mean dengan ketahanan median (NIST/SEMATECH, n.d.).
Dalam praktik, saya sekarang mencatat ketiganya sebelum menulis kesimpulan apa pun. Mean berguna untuk total dan perhitungan yang harus menjumlahkan semua nilai, misalnya anggaran bulanan. Median berguna untuk menggambarkan nilai khas pada data yang condong, misalnya nilai transaksi atau pendapatan. Modus berguna untuk melihat kategori atau nilai yang paling sering terjadi. MathWorks mencatat bahwa satu nilai buruk dapat menggeser mean sejauh yang tidak terbatas, sedangkan median hanya berubah sedikit (MathWorks, n.d.). Itu sebabnya saya tidak pernah membaca mean tanpa melihat median di sebelahnya.
Contoh sederhana memperlihatkan perbedaannya. Ambil sembilan nilai: 2, 3, 3, 4, 5, 5, 5, 6, 7. Mean-nya 40 dibagi 9, sekitar 4,44. Median-nya 5, modusnya 5. Sekarang tambahkan satu nilai 30. Mean naik menjadi 70 dibagi 10, yaitu 7,00, sementara median tetap 5 dan modus tetap 5. Satu nilai itu cukup untuk menggeser mean sejauh hampir tiga satuan, padahal sembilan dari sepuluh nilai tidak berubah. Ilustrasi berikut menunjukkan kejadian itu.

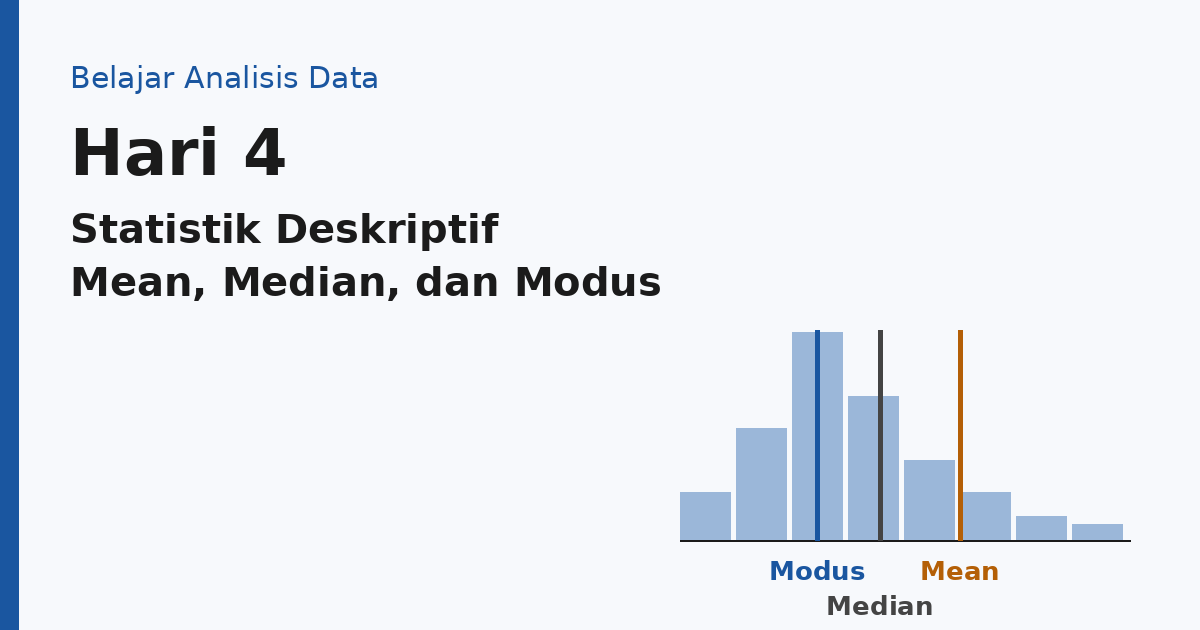
Bentuk distribusi menentukan posisi ketiganya. Pada distribusi simetris, mean, median, dan modus berada di tengah yang sama. Pada distribusi condong (skewed), mean tertarik ke arah ekor yang panjang. NIST menyebut bahwa pada distribusi condong mean dan median tidak sama, dan mean bergeser ke arah kemencengan (NIST/SEMATECH, n.d.). Diagram berikut menggambarkan distribusi condong ke kanan.
Contoh kode
Contoh berikut memakai dataset penguins, sama seperti pada Hari 3. Dataset ini berisi pengukuran penguin di Kepulauan Palmer, Antartika, bukan data manusia. Kolom yang dipakai adalah body_mass_g, yaitu massa tubuh dalam gram, yang merupakan variabel rasio. Baris dengan nilai kosong dibuang lebih dulu.
-- SQL (PostgreSQL): mean, median, dan modus untuk body_mass_g
SELECT
  AVG(body_mass_g)                                          AS mean,    -- jumlah dibagi banyak data
  PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY body_mass_g)  AS median,  -- nilai tengah
  MODE() WITHIN GROUP (ORDER BY body_mass_g)                AS modus    -- nilai paling sering muncul
FROM penguins
WHERE body_mass_g IS NOT NULL;   -- nilai kosong dibuang secara eksplisit
# Python (pandas)
import seaborn as sns
# Dataset bawaan seaborn; sumber asli: Horst, Hill, & Gorman (2020)
penguins = sns.load_dataset("penguins").dropna(subset=["body_mass_g"])
massa = penguins["body_mass_g"]
print("Mean :", massa.mean())
print("Median:", massa.median())
print("Modus :", massa.mode().tolist()) # bisa berisi lebih dari satu nilai# R (tidyverse)
library(tidyverse)
library(palmerpenguins) # dataset penguins, Horst, Hill, & Gorman (2020)
# R tidak punya fungsi modus bawaan untuk data numerik; ini versi sederhana
modus <- function(x) {
ux <- unique(x)
ux[which.max(tabulate(match(x, ux)))] # nilai dengan frekuensi tertinggi
}
penguins |>
drop_na(body_mass_g) |>
summarise(
mean = mean(body_mass_g),
median = median(body_mass_g),
modus = modus(body_mass_g)
)Perhatikan bahwa modus pada data massa tubuh sering kali tidak banyak memberi informasi, karena pengukuran kontinu jarang berulang persis sama. Hasil modus di sini sebaiknya dibaca sebagai petunjuk kasar, bukan ringkasan utama.
Contoh kecil
Contoh kecil. Sebuah toko kecil mencatat sembilan transaksi bernilai Rp50.000 dan satu transaksi bernilai Rp5.000.000. Mean-nya sekitar Rp545.000, angka yang tidak mewakili transaksi mana pun. Median-nya Rp50.000, dan modusnya juga Rp50.000. Untuk laporan kepada pemilik toko, median lebih jujur menggambarkan transaksi khas, sementara mean tetap perlu dilaporkan bersama total penjualan.
Kesalahan yang sering terjadi
Waspadai tiga hal ini:
- Menulis “rata-rata” tanpa menyebut apakah yang dimaksud mean atau median. Pembaca laporan bisa menafsirkan angka itu secara berbeda.
- Menghitung modus pada data kontinu yang hampir semua nilainya unik, lalu menganggap hasilnya bermakna.
- Melaporkan mean untuk data yang sangat condong tanpa median sebagai pembanding, sehingga ekor panjang tidak terlihat.
Latihan
- Hitung mean, median, dan modus dari data 4, 6, 6, 7, 9, 10, 40.
- Dari ketiga ukuran pada soal 1, mana yang paling mewakili data itu, dan mengapa?
Kunci jawaban singkat: (1) Jumlahnya 82, dibagi 7 data sehingga mean sekitar 11,71. Median adalah nilai ke-4 setelah diurutkan, yaitu 7. Modusnya 6, karena muncul dua kali. (2) Median 7 paling mewakili, karena nilai 40 menarik mean ke atas. Sebagian besar data berada di sekitar 4 sampai 10.
Ringkasan
Mean menggunakan setiap nilai sehingga peka terhadap nilai ekstrem, median bergantung pada posisi sehingga lebih tahan, dan modus menunjukkan nilai yang paling sering muncul. Sebelum memilih satu ukuran, periksa dulu bentuk datanya. Besok kita membahas persentil, kuartil, dan boxplot, yang menunjukkan sebaran data di sekitar median.
Sumber bacaan
MathWorks. (n.d.). Measures of central tendency. https://www.mathworks.com/help/stats/measures-of-central-tendency.html
NIST/SEMATECH. (n.d.). e-Handbook of statistical methods, 1.3.5.1 Measures of location. https://itl.nist.gov/div898/handbook/eda/section3/eda351.htm
OpenStax. (n.d.). Introductory Statistics 2e, 2.5 Measures of the center of the data. https://openstax.org/books/introductory-statistics-2e/pages/2-5-measures-of-the-center-of-the-data
PTC. (n.d.). Mathcad Help: Example: Location estimators. https://support.ptc.com/help/mathcad/r10.0/en/PTC_Mathcad_Help/example_location_estimators.html
Horst, A. M., Hill, A. P., & Gorman, K. B. (2020). palmerpenguins: Palmer Archipelago (Antarctica) penguin data. https://doi.org/10.5281/zenodo.3960218
Navigasi seri Belajar Analisis Data
- Sebelumnya: Hari 3, Jenis Data dan Tipe Variabel
- Berikutnya: Hari 5, Persentil, Kuartil, dan Boxplot (terbit 15 November 2026 pukul 09.00 WIB)
- Semua tulisan seri Belajar Analisis Data
Tinggalkan Balasan