
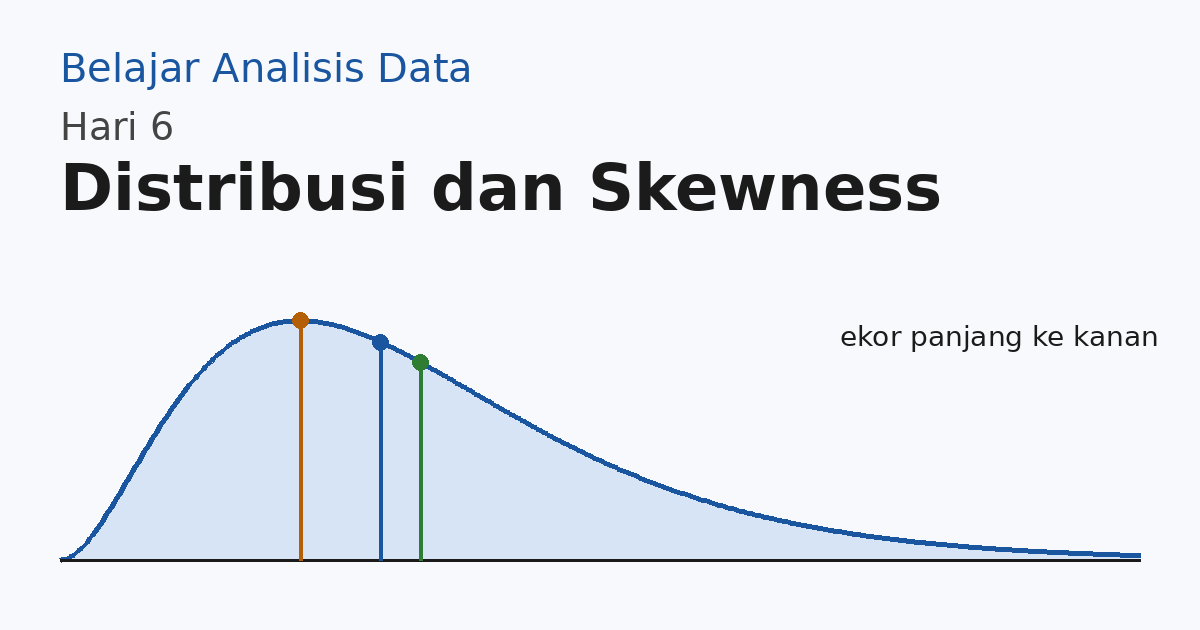
Ringkasan: Distribusi menggambarkan pola sebaran nilai, dan skewness mengukur seberapa tidak simetris pola itu. Bagi data analyst, membaca arah skewness membantu memilih ukuran pusat yang tepat, sebab mean dan median bisa bercerita berbeda tentang data yang sama.
Tujuan belajar
- Membedakan distribusi simetris dari distribusi skewed kiri atau skewed kanan, baik dari histogram maupun dari data mentah.
- Menghitung dan menafsirkan nilai skewness, serta memahami perbedaan rumus populasi dan rumus sampel.
- Menjelaskan mengapa mean lebih peka terhadap nilai ekstrem dibanding median.
Konsep inti
Distribusi adalah gambaran tentang seberapa sering tiap nilai muncul dalam data. Waktu pertama belajar, saya mengira ini cuma soal grafik batang. Ternyata bentuk distribusi menentukan ukuran pusat mana yang masuk akal untuk dilaporkan.
Skewness adalah ukuran simetri, atau lebih tepatnya ketiadaan simetri. NIST mendefinisikan data simetris sebagai data yang tampak sama di kiri dan kanan titik tengahnya (NIST/SEMATECH, n.d.). Skewness negatif berarti ekor kiri lebih panjang, sedangkan skewness positif berarti ekor kanan lebih panjang. Distribusi normal memiliki skewness nol.
Rumus yang diberikan NIST untuk skewness g1 adalah rata-rata pangkat tiga selisih tiap nilai dari mean, dibagi s pangkat tiga. Simpangan baku s di sini dihitung dengan N, bukan N−1 (NIST/SEMATECH, n.d.). Banyak perangkat lunak justru menghitung versi terkoreksi, G1 = √(N(N−1)) / (N−2) × g1, yang mendekati g1 ketika N besar. Pada data latihan saya di bawah, hasil .skew() di pandas sama dengan G1, bukan g1. Jadi sebelum membandingkan dua angka, cek dulu rumus yang dipakai.
Saat membaca skewness, saya membandingkan mean, median, dan modus. Mean memakai semua nilai, sehingga satu nilai ekstrem bisa menggesernya. Median hanya bergantung pada posisi tengah data yang sudah diurutkan. Modus adalah nilai yang paling sering muncul. Pada ilustrasi berikut, yang memakai kurva gamma berbentuk skewed kanan, modus berada paling kiri dan mean paling kanan. Pola ini tidak berlaku untuk semua data. NIST mencatat bahwa data multimodal bisa mengubah tanda skewness (NIST/SEMATECH, n.d.).

Contoh bidang yang disebut NIST adalah waktu kegagalan, yang tidak mungkin negatif dan karena itu cenderung skewed kanan (NIST/SEMATECH, n.d.). Untuk skewness kanan yang sedang, NIST menyebut transformasi log atau akar kuadrat sering membantu membuat data lebih mendekati normal (NIST/SEMATECH, n.d.).
Diagram berikut merangkum tiga bentuk yang paling sering saya temui saat berlatih.
Contoh kode
Ketiga contoh memakai data sintetis 2, 2, 3, 3, 3, 4, 5, 6, 8, 12. Hasil yang diharapkan: mean 4,8; median 3,5; modus 3; G1 = 1,529 (pandas); dan g1 = 1,289 (rumus populasi seperti di NIST).
-- SQL (PostgreSQL): skewness g1 (rumus populasi) dengan agregasi biasa
WITH data(nilai) AS (
  VALUES (2), (2), (3), (3), (3), (4), (5), (6), (8), (12)
),
statistik AS (
  SELECT AVG(nilai) AS mu, STDDEV_POP(nilai) AS sd FROM data
)
SELECT AVG(POWER((d.nilai - s.mu) / s.sd, 3)) AS g1  -- hasil: 1,289
FROM data d
CROSS JOIN statistik s;
# Python (pandas): mean, median, modus, dan skewness
import pandas as pd
import numpy as np
nilai = pd.Series([2, 2, 3, 3, 3, 4, 5, 6, 8, 12])
mean = nilai.mean() # 4,8
median = nilai.median() # 3,5
modus = nilai.mode().tolist() # [3]
skew_g1_sampel = nilai.skew() # 1,529 (G1, versi terkoreksi)
# Menghitung g1 dengan rumus populasi, seperti di NIST
d = nilai - mean
s_populasi = np.sqrt((d ** 2).mean())
g1 = (d ** 3).mean() / s_populasi ** 3 # 1,289
print("mean:", mean, "| median:", median, "| modus:", modus)
print("G1 (pandas):", round(skew_g1_sampel, 3), "| g1 (populasi):", round(g1, 3))# R (tidyverse): mean, median, dan g1 dengan rumus populasi
library(tidyverse)
tibble(nilai = c(2, 2, 3, 3, 3, 4, 5, 6, 8, 12)) |>
summarise(
mean = mean(nilai), # 4,8
median = median(nilai), # 3,5
g1 = {
d <- nilai - mean(nilai)
mean(d^3) / sqrt(mean(d^2))^3 # 1,289
}
)Contoh kecil. Ganti nilai 12 pada data di atas dengan 40. Mean naik dari 4,8 menjadi 7,6, sedangkan median tetap 3,5 dan modus tetap 3. G1 naik dari 1,53 menjadi 3,01. Satu nilai ekstrem sudah cukup untuk menggeser mean dan membuat skewness melonjak, tetapi median hampir tidak bergerak.
Kesalahan yang sering terjadi
Waspadai tiga hal ini:
- Membandingkan skewness dari rumus populasi (1,289) dengan hasil pandas (1,529) tanpa menyadari perbedaan N dan N−1.
- Menyimpulkan bentuk distribusi dari satu ukuran saja. Mean tanpa median atau tanpa melihat histogram bisa menyesatkan.
- Membuang nilai ekstrem begitu saja. Nilai ekstrem perlu diperiksa dulu, karena bisa jadi salah input, bisa juga informasi yang justru penting.
Latihan
Gunakan data 4, 6, 7, 7, 8, 9, 10, 12, 20.
- Hitung mean, median, dan modus data tersebut.
- Tentukan arah skewness data tersebut dan jelaskan alasanmu dengan membandingkan mean, median, dan modus.
- Ganti nilai 20 dengan 40. Berapa mean dan median yang baru? Mana yang lebih berubah, dan mengapa?
Kunci jawaban singkat: (1) mean = 83/9 ≈ 9,22; median = 8; modus = 7. (2) Skewed kanan, karena mean (9,22) lebih besar daripada median (8), yang lebih besar daripada modus (7), dan ekor data memanjang ke nilai 20. Pandas memberi skewness G1 sekitar 1,709. (3) Mean menjadi 103/9 ≈ 11,44, sedangkan median tetap 8. Mean lebih berubah karena semua nilai ikut dihitung.
Ringkasan
Distribusi menunjukkan bentuk sebaran data, dan skewness merangkum seberapa condong bentuk itu ke salah satu sisi. Mean, median, dan modus memberi posisi pusat yang berbeda, dan selisihnya sering menjadi petunjuk awal. Besok kita membahas korelasi dan kausalitas, yaitu mengapa dua variabel yang bergerak bersama belum tentu saling menyebabkan.
Sumber bacaan
NIST/SEMATECH. (n.d.). 1.3.5.11. Measures of skewness and kurtosis. e-Handbook of Statistical Methods. https://www.itl.nist.gov/div898/handbook/eda/section3/eda35b.htm
Navigasi seri Belajar Analisis Data
- Sebelumnya: Hari 5, Persentil, Kuartil, dan Boxplot
- Berikutnya: Hari 7, Korelasi dan Kausalitas (terbit 17 November 2026 pukul 09.00 WIB)
- Semua tulisan seri Belajar Analisis Data
Tinggalkan Balasan