
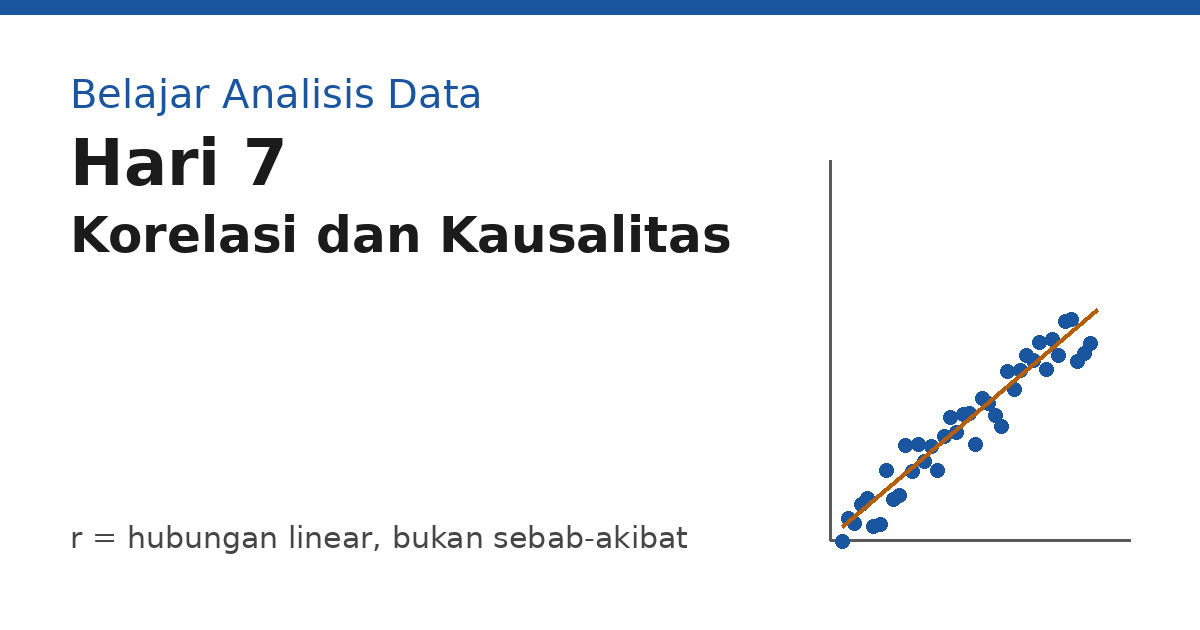
Ringkasan: Korelasi mengukur seberapa kuat dua variabel bergerak bersama, sedangkan kausalitas menjawab apakah satu variabel benar-benar menyebabkan perubahan pada yang lain. Sebagai calon data analyst, saya ingin tahu kapan angka korelasi layak dijadikan dasar keputusan dan kapan ia justru harus dicurigai.
Tujuan belajar
- Menghitung dan membaca koefisien korelasi Pearson (r), termasuk arah dan kekuatannya.
- Menjelaskan mengapa korelasi tidak otomatis berarti sebab-akibat.
- Mengenali variabel perancu (confounder) dan cara memeriksanya.
Konsep inti
Koefisien korelasi Pearson mengukur kekuatan dan arah hubungan linear antara dua variabel numerik. Nilainya berada di antara -1 dan +1. Nilai mendekati +1 berarti keduanya cenderung naik bersama, nilai mendekati -1 berarti yang satu naik ketika yang lain turun, dan nilai mendekati 0 berarti tidak ada hubungan linear yang berarti (NIST/SEMATECH, 2012). Kuadrat dari r (r²) dapat dibaca sebagai proporsi variasi satu variabel yang dapat dijelaskan secara linear oleh variabel lainnya (NIST/SEMATECH, 2012).
Korelasi hanya menjawab pertanyaan “apakah dua hal bergerak bersama?”. Pertanyaan “apakah yang satu menyebabkan yang lain?” membutuhkan lebih banyak syarat: urutan waktu yang jelas, tidak adanya variabel ketiga yang menggerakkan keduanya, dan idealnya desain studi yang memungkinkan intervensi. Kerangka berpikir kausal ini dibahas lebih dalam oleh Pearl (2009) dan Hernán dan Robins (2020). Saya masih pemula, jadi bagian buku-buku itu saya baca pelan-pelan dan belum semuanya saya pahami.

Urutan pertanyaan yang sekarang saya pakai sebelum menulis kata “menyebabkan” adalah sebagai berikut:
Contoh dengan data sintetis
Agar hubungannya terlihat jelas, saya membuat data sintetis 30 siswa berisi jam belajar per minggu dan nilai ujian. Nilai dibentuk dari hubungan linear dengan jam belajar ditambah derau acak. Hasilnya nilai r sebesar 0,818. Karena data ini sengaja dibuat, ia tidak boleh dipakai sebagai bukti tentang siswa nyata.
# Python (pandas): hitung korelasi Pearson
import pandas as pd

df = pd.read_csv("data_sintetis.csv")
r = df["jam_belajar"].corr(df["nilai_ujian"])  # Pearson adalah metode default
print(round(r, 3))  # hasil: 0.818

# Matriks korelasi untuk semua kolom numerik
print(df.select_dtypes("number").corr().round(3))
-- SQL (PostgreSQL): corr() adalah agregat bawaan untuk korelasi Pearson
SELECT corr(jam_belajar, nilai_ujian) AS r
FROM nilai_siswa;# R (tidyverse): ringkasan korelasi dan uji signifikansinya
library(tidyverse)
df <- read_csv("data_sintetis.csv")
df |> summarise(r = cor(jam_belajar, nilai_ujian))
# Uji korelasi lengkap, termasuk nilai p dan interval kepercayaan
cor.test(df$jam_belajar, df$nilai_ujian)Contoh kecil
Pada data sintetis di atas, r = 0,818 dan r² = 0,669. Artinya sekitar 67% variasi nilai ujian dapat dijelaskan secara linear oleh jam belajar dalam data ini. Namun, data tersebut dibuat dengan hubungan sebab yang sudah disisipkan, sehingga angka ini tidak membuktikan apa pun tentang kehidupan nyata.
Mengenali variabel perancu
Contoh klasiknya adalah es krim dan kejadian tenggelam. Keduanya cenderung meningkat bersama dalam data yang dikumpulkan sepanjang musim panas, tetapi es krim tidak menyebabkan orang tenggelam. Suhu udara yang panas memengaruhi keduanya, dan suhu itulah variabel perancu. Ada beberapa cara memeriksanya: membagi data ke dalam kelompok suhu lalu melihat hubungannya di tiap kelompok, memasukkan suhu sebagai variabel kontrol dalam regresi, atau merancang studi yang memungkinkan kita mengatur salah satu variabel secara langsung.
Kesalahan yang sering terjadi
- Menyimpulkan sebab hanya karena r tinggi. Angka korelasi tidak menyebutkan arah sebab.
- Mengira r mendekati 0 berarti tidak ada hubungan. Pearson hanya mengukur hubungan linear, jadi hubungan melengkung bisa tampak lemah.
- Membiarkan satu titik ekstrem mendominasi hasil. Selalu lihat scatter plot sebelum mempercayai angka r.
Latihan
- Sebuah laporan menunjukkan r = -0,92 antara jam pelatihan staf per bulan dan jumlah keluhan pasien per bulan. Apa kesimpulan paling aman? Kunci: Ini hubungan negatif yang kuat secara linear. Ia belum menunjukkan sebab. Periksa urutan waktu, variabel ketiga seperti jumlah pasien atau musim, dan bentuk scatter plot.
- Jika r = 0,5, berapa nilai r² dan apa maknanya? Kunci: r² = 0,25, yang berarti sekitar 25% variasi satu variabel dapat dijelaskan secara linear oleh variabel lainnya. Angka 0,5 bukan berarti “setengah sebab”.
- Anda menghitung r = 0,85, tetapi scatter plot memperlihatkan satu titik ekstrem di pojok kanan atas. Apa langkahmu? Kunci: Telusuri asal data titik itu, hitung ulang r dengan dan tanpa titik tersebut, lalu bandingkan dengan korelasi Spearman yang berbasis peringkat. Laporkan keduanya beserta alasan pemilihan metode.
Ringkasan
Korelasi adalah petunjuk, bukan putusan. Angka r membantu melihat pola, tetapi klaim sebab membutuhkan pengetahuan tentang konteks, urutan waktu, dan desain data. Besok, pada Hari 8, saya masuk ke spreadsheet: rumus dasar dan referensi sel, yang dijadwalkan terbit pada 18 November 2026 pukul 09.00 WIB.
Referensi
NIST/SEMATECH. (2012). e-Handbook of Statistical Methods. https://www.itl.nist.gov/div898/handbook/
Hernán, M. A., & Robins, J. M. (2020). Causal Inference: What If. Chapman & Hall/CRC.
Pearl, J. (2009). Causality (2nd ed.). Cambridge University Press.
Navigasi seri Belajar Analisis Data
- Berikutnya: Hari 8, Spreadsheet: rumus dasar dan referensi sel (terbit 18 November 2026 pukul 09.00 WIB)
- Semua tulisan seri Belajar Analisis Data
- Sebelumnya: Hari 6, Distribusi dan Skewness
Catatan data: seluruh contoh angka memakai data sintetis yang saya buat sendiri dengan generator acak ber-seed tetap (seed 2026). Tidak ada data pasien atau data pribadi nyata di dalam tulisan ini.

Tinggalkan Balasan