
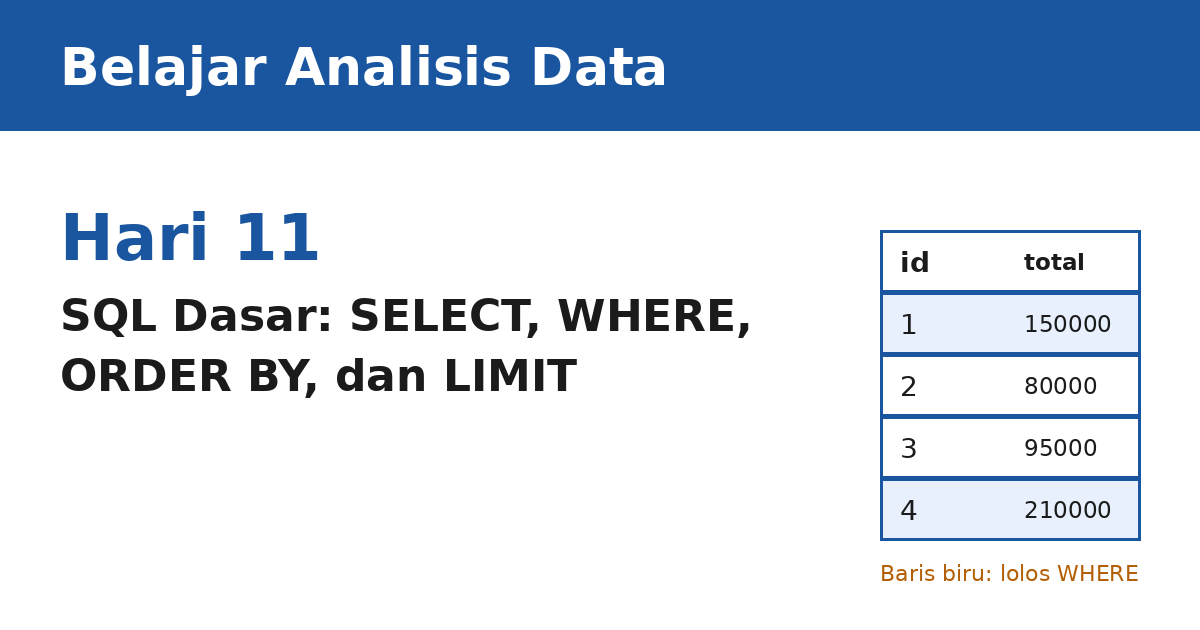
Ringkasan: SELECT, WHERE, ORDER BY, dan LIMIT adalah empat klausa SQL dasar yang dipakai hampir setiap hari oleh data analyst untuk mengambil, menyaring, dan mengurutkan data dari satu tabel. Di tulisan ini saya mencatat urutan penulisannya, contoh query dengan data sintetis, dan dua kesalahan yang paling sering membuat hasil saya meleset.
Tujuan belajar
- Menulis query SELECT yang memilih kolom tertentu dan memberi alias pada hasilnya.
- Menyaring baris dengan WHERE, termasuk IN, BETWEEN, dan pemeriksaan NULL.
- Mengurutkan hasil dengan ORDER BY dan membatasi jumlah baris dengan LIMIT.
Konsep inti
SQL (Structured Query Language) adalah bahasa untuk meminta data dari basis data relasional. Waktu pertama belajar, saya mengira query dibaca dari atas ke bawah, sesuai urutan penulisannya. Ternyata urutan penulisan dan urutan pemrosesannya berbeda, dan selisih itu menjelaskan sebagian besar error yang saya temui.
Urutan penulisannya adalah SELECT, FROM, WHERE, ORDER BY, lalu LIMIT. Secara logis, mesin basis data memproses FROM dan WHERE lebih dulu, baru SELECT, kemudian ORDER BY dan LIMIT (PostgreSQL Global Development Group, n.d.-a). Itu sebabnya WHERE belum tahu apa pun tentang alias yang dibuat di SELECT, seperti yang akan saya bahas di bagian kesalahan.

Diagram berikut merangkum urutan pemrosesan kelima klausa itu.
SELECT memilih kolom yang ditampilkan. Tanda bintang (*) mengambil semua kolom, tetapi saya lebih suka menulis nama kolom satu per satu supaya query tetap jelas ketika tabel berubah. AS memberi nama baru pada hasil, misalnya total AS nilai_pesanan.
WHERE menyaring baris yang kondisinya bernilai benar. Operator yang paling sering saya pakai adalah =, <>, >=, BETWEEN, IN, dan IS NULL. ORDER BY mengurutkan hasil secara naik (ASC, bawaan) atau turun (DESC). LIMIT membatasi jumlah baris yang dikembalikan.
NULL berarti nilai tidak diketahui atau tidak ada. NULL tidak sama dengan nol, dan tidak sama dengan teks kosong. Karena itu, perbandingan dengan tanda sama dengan tidak pernah bernilai benar untuk NULL. Gunakan IS NULL atau IS NOT NULL (PostgreSQL Global Development Group, n.d.-b).
Contoh kode
Contoh berikut memakai tabel pesanan sintetis yang saya karang sendiri, bukan data pelanggan nyata. Tabelnya berisi lima baris:
id_pesanan | pelanggan | kota        | total  | status
1          | Andi      | Sragen       | 150000 | selesai
2          | Rina      | Solo         | 80000  | batal
3          | Budi      | Sragen       | 95000  | selesai
4          | Sari      | Yogyakarta   | 210000 | selesai
5          | Dedi      | Solo         | 45000  | proses
-- SQL: pesanan selesai dengan total minimal 100000, dari yang terbesar, dua teratas
SELECT id_pesanan, pelanggan, total
FROM pesanan
WHERE status = 'selesai'
AND total >= 100000
ORDER BY total DESC
LIMIT 2;
-- Hasil: pesanan 4 (210000) dan pesanan 1 (150000)# Python (pandas)
import pandas as pd
pesanan = pd.DataFrame({
"id_pesanan": [1, 2, 3, 4, 5],
"pelanggan": ["Andi", "Rina", "Budi", "Sari", "Dedi"],
"kota": ["Sragen", "Solo", "Sragen", "Yogyakarta", "Solo"],
"total": [150000, 80000, 95000, 210000, 45000],
"status": ["selesai", "batal", "selesai", "selesai", "proses"],
})
# Setara WHERE: simpan baris yang kondisinya benar, lalu pilih kolom (SELECT)
hasil = pesanan.loc[
(pesanan["status"] == "selesai") & (pesanan["total"] >= 100000),
["id_pesanan", "pelanggan", "total"],
]
# Setara ORDER BY total DESC dan LIMIT 2
hasil = hasil.sort_values("total", ascending=False).head(2)
print(hasil)# R (tidyverse)
library(tidyverse)
pesanan <- tibble(
id_pesanan = 1:5,
pelanggan = c("Andi", "Rina", "Budi", "Sari", "Dedi"),
kota = c("Sragen", "Solo", "Sragen", "Yogyakarta", "Solo"),
total = c(150000, 80000, 95000, 210000, 45000),
status = c("selesai", "batal", "selesai", "selesai", "proses")
)
pesanan |>
filter(status == "selesai", total >= 100000) |> # WHERE
select(id_pesanan, pelanggan, total) |> # SELECT
arrange(desc(total)) |> # ORDER BY
slice_head(n = 2) # LIMIT 2Contoh kecil
Untuk menyaring pesanan dari dua kota dengan total antara 50.000 dan 150.000, saya menulis SELECT id_pesanan, pelanggan, total FROM pesanan WHERE kota IN ('Sragen', 'Solo') AND total BETWEEN 50000 AND 150000;. Hasilnya pesanan 1, 2, dan 3. Pesanan 4 tidak lolos karena kotanya Yogyakarta, dan pesanan 5 tidak lolos karena totalnya 45.000. BETWEEN bersifat inklusif, jadi pesanan dengan total tepat 150.000 tetap ikut.
Kesalahan yang sering terjadi
Waspadai tiga hal ini:
- Memakai alias di WHERE. Query seperti
SELECT total * 1.1 AS total_pajak FROM pesanan WHERE total_pajak > 100000;ditolak PostgreSQL karena WHERE diproses sebelum alias dibuat. Tulis ulang ekspresinya di WHERE. - Menulis
WHERE status = NULL. Query ini tidak mengembalikan baris apa pun, dan saya sempat mengira datanya memang kosong. GunakanIS NULL. - Memakai LIMIT tanpa ORDER BY. Tanpa pengurutan, baris yang diambil tidak dijamin sama setiap kali query dijalankan. Setiap kali saya ingin “data teratas”, saya selalu menambahkan ORDER BY lebih dulu.
Latihan
Gunakan tabel pesanan dari bagian contoh kode.
- Tulis query untuk pesanan dari kota Solo dengan status selesai atau proses. Ambil id_pesanan dan total, lalu urutkan dari total terkecil.
- Tulis query untuk tiga pesanan dengan total terbesar, dari status apa pun.
- Apa yang salah pada query
SELECT pelanggan FROM pesanan WHERE status = NULL;, dan bagaimana memperbaikinya?
Kunci jawaban singkat: (1) SELECT id_pesanan, total FROM pesanan WHERE kota = 'Solo' AND status IN ('selesai', 'proses') ORDER BY total ASC; hanya menghasilkan pesanan 5 dengan total 45.000, karena pesanan 2 berstatus batal. (2) SELECT id_pesanan, pelanggan, total FROM pesanan ORDER BY total DESC LIMIT 3; menghasilkan pesanan 4, 1, dan 3. (3) Tanda sama dengan tidak bisa membandingkan NULL. Ganti menjadi WHERE status IS NULL.
Ringkasan
SELECT, WHERE, ORDER BY, dan LIMIT cukup untuk banyak pertanyaan sederhana terhadap satu tabel. Ingat urutan pemrosesannya, jangan memakai alias di WHERE, dan selalu gunakan IS NULL untuk memeriksa nilai kosong. Besok, pada Hari 12, saya lanjut ke agregasi dengan GROUP BY dan HAVING, yang dijadwalkan terbit 22 November 2026 pukul 09.00 WIB.
Sumber bacaan
PostgreSQL Global Development Group. (n.d.-a). SELECT. PostgreSQL documentation. https://www.postgresql.org/docs/current/sql-select.html
PostgreSQL Global Development Group. (n.d.-b). Comparison functions and operators. PostgreSQL documentation. https://www.postgresql.org/docs/current/functions-comparison.html
dplyr. (n.d.). slice: Subset rows using their positions. tidyverse documentation. https://dplyr.tidyverse.org/reference/slice.html
pandas development team. (n.d.). pandas.DataFrame.sort_values. pandas documentation. https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.sort_values.html
Catatan data: seluruh contoh angka pada tulisan ini adalah data sintetis yang saya buat sendiri. Tidak ada data pasien atau data pribadi nyata di dalamnya.
Navigasi seri Belajar Analisis Data
- Berikutnya: Hari 12, SQL: agregasi dengan GROUP BY dan HAVING (terbit 22 November 2026 pukul 09.00 WIB)
- Semua tulisan seri Belajar Analisis Data: https://legawa.com/tag/data-analyst/
- Sebelumnya: Hari 10, XLOOKUP dan INDEX-MATCH

Tinggalkan Balasan