
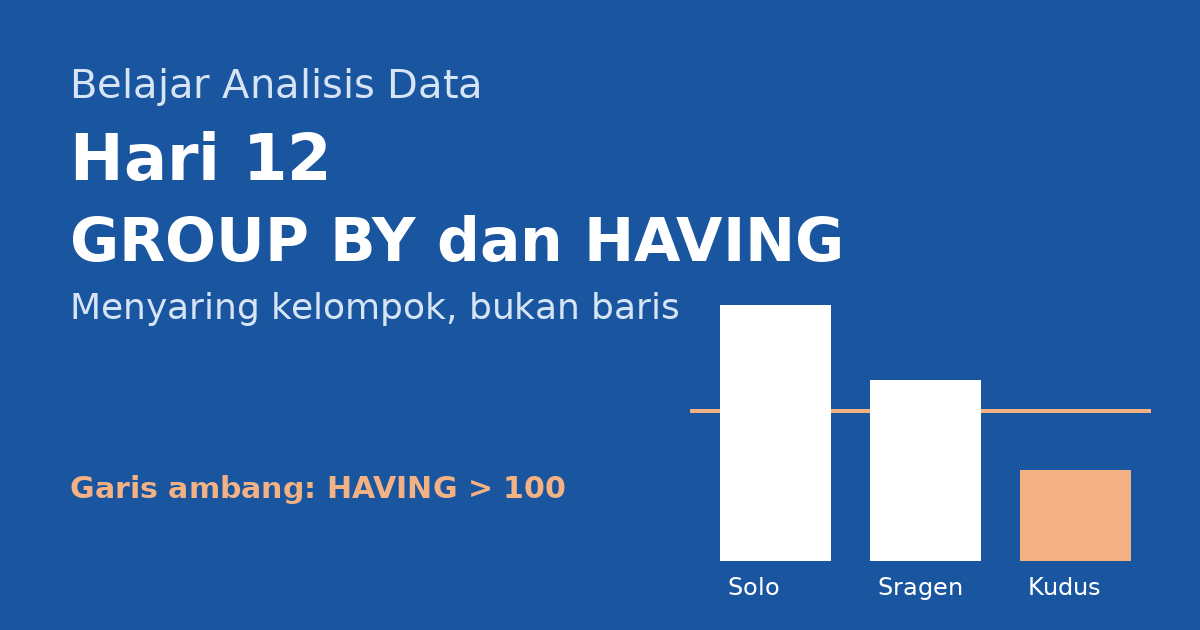
Ringkasan: GROUP BY mengelompokkan baris yang memiliki nilai sama, lalu fungsi agregat seperti COUNT dan SUM meringkas setiap kelompok, dan HAVING menyaring kelompok itu setelah angkanya dihitung. Bagi data analyst pemula, perbedaan antara WHERE dan HAVING sering menjadi sumber hasil yang meleset, jadi saya mencatatnya dengan contoh yang bisa dijalankan ulang.
Tujuan belajar
- Menulis query GROUP BY dengan fungsi agregat COUNT dan SUM.
- Membedakan WHERE yang menyaring baris dari HAVING yang menyaring kelompok.
- Menuliskan logika yang sama di pandas dan tidyverse, lalu memeriksa apakah hasilnya cocok.
Konsep inti
Saat pertama kali membaca query GROUP BY, saya mengira klausa itu hanya mengurutkan data. Ternyata ia membuat kelompok baru. Setiap baris dengan nilai kolom yang sama masuk ke kelompok yang sama, lalu fungsi agregat dihitung untuk tiap kelompok. PostgreSQL menggambarkan WHERE, GROUP BY, dan HAVING sebagai rangkaian transformasi berurutan terhadap tabel hasil FROM, dan hasil akhirnya baru diteruskan ke daftar SELECT (PostgreSQL Global Development Group, n.d.).

Pembedaan yang paling penting ada di sini. WHERE bekerja pada baris sebelum pengelompokan, sedangkan HAVING bekerja pada kelompok setelah fungsi agregat dihitung. DataCamp merangkumnya dengan cara serupa: WHERE menyaring baris sebelum agregasi, dan HAVING menerapkan kondisi setelah agregasi (DataCamp, n.d.). Karena itu, kondisi yang memakai SUM(total) atau COUNT(*) harus ditulis di HAVING. Hasil agregat belum ada ketika WHERE dijalankan.
Pandas punya padanan konsep ini lewat groupby. Dokumentasi pandas menyebut bahwa groupby menyerupai GROUP BY di SQL, dan parameter as_index=False menghasilkan keluaran yang bergaya SQL, dengan kolom kelompok tetap menjadi kolom biasa (pandas development team, n.d.). Bawaan parameter dropna adalah True, sehingga baris dengan kunci kelompok kosong dibuang dari hasil. Hal ini perlu diingat ketika total gabungan tidak cocok dengan tabel sumber.
Contoh kode
Contoh berikut memakai data pesanan sintetis yang sama dengan Hari 11, berisi lima baris dari tiga kota. Setiap contoh menghitung jumlah pesanan selesai dan total penjualannya per kota, lalu hanya menampilkan kota dengan total di atas 220000.
-- SQL (PostgreSQL): total pesanan selesai per kota, hanya kota di atas 220000
SELECT
  kota,
  COUNT(*)   AS jumlah_pesanan,
  SUM(total) AS total_penjualan
FROM pesanan
WHERE status = 'selesai'            -- menyaring baris sebelum dikelompokkan
GROUP BY kota                       -- satu kelompok per kota
HAVING SUM(total) > 220000          -- menyaring kelompok setelah dijumlahkan
ORDER BY total_penjualan DESC;
-- hasil: Sragen, 2 pesanan, total 245000
# Python (pandas)
import pandas as pd
pesanan = pd.DataFrame({
"id_pesanan": [1, 2, 3, 4, 5],
"pelanggan": ["Andi", "Rina", "Budi", "Sari", "Dedi"],
"kota": ["Sragen", "Solo", "Sragen", "Yogyakarta", "Solo"],
"total": [150000, 80000, 95000, 210000, 45000],
"status": ["selesai", "batal", "selesai", "selesai", "proses"],
})
# WHERE: saring baris
selesai = pesanan[pesanan["status"] == "selesai"]
# GROUP BY dan agregat; as_index=False agar hasil bergaya SQL
per_kota = (
selesai.groupby("kota", as_index=False)
.agg(jumlah_pesanan=("id_pesanan", "count"),
total_penjualan=("total", "sum"))
)
# HAVING: saring kelompok, lalu urutkan (ORDER BY)
hasil = (per_kota[per_kota["total_penjualan"] > 220000]
.sort_values("total_penjualan", ascending=False))
print(hasil) # Sragen, 2, 245000# R (tidyverse)
library(tidyverse)
pesanan <- tibble(
id_pesanan = 1:5,
pelanggan = c("Andi", "Rina", "Budi", "Sari", "Dedi"),
kota = c("Sragen", "Solo", "Sragen", "Yogyakarta", "Solo"),
total = c(150000, 80000, 95000, 210000, 45000),
status = c("selesai", "batal", "selesai", "selesai", "proses")
)
pesanan |>
filter(status == "selesai") |> # WHERE
group_by(kota) |> # GROUP BY
summarise(
jumlah_pesanan = n(),
total_penjualan = sum(total),
.groups = "drop"
) |>
filter(total_penjualan > 220000) |> # HAVING
arrange(desc(total_penjualan)) # ORDER BYContoh kecil
Bandingkan dua query pada data yang sama. Jika kondisi total > 100000 ditaruh di WHERE, yang disaring adalah pesanan satu per satu. Hasilnya hanya Sragen dengan 150000 dan Yogyakarta dengan 210000, sedangkan Solo hilang sepenuhnya. Jika kondisi SUM(total) > 100000 ditaruh di HAVING, total setiap kota dihitung dulu: Sragen 245000, Solo 125000, dan Yogyakarta 210000, sehingga ketiganya lolos.
Kesalahan yang sering terjadi
Waspadai tiga hal ini:
- Menaruh kondisi agregat di WHERE, misalnya WHERE SUM(total) > 100000. Kondisi seperti ini harus pindah ke HAVING, karena WHERE diproses sebelum pengelompokan.
- Memakai alias dari SELECT di WHERE atau HAVING. Alias baru dibuat setelah HAVING diproses, sehingga belum dikenal di sana. Tulis ulang ekspresi aslinya.
- Di pandas, mengandalkan groupby tanpa memeriksa dropna. Dengan bawaan dropna=True, kelompok berkunci kosong dibuang, sehingga total gabungan bisa berbeda dari tabel sumber. Gunakan dropna=False bila kelompok kosong harus ikut dihitung.
Latihan
- Dari tabel pesanan dengan semua status (tanpa WHERE), tulis query yang menampilkan kota dengan total penjualan di atas 150000 beserta jumlah pesanannya.
- Query berikut gagal: SELECT kota, SUM(total) AS t FROM pesanan GROUP BY kota HAVING t > 150000; Apa masalahnya, dan bagaimana memperbaikinya?
- Apa perbedaan hasil groupby(“kota”) dan groupby(“kota”, as_index=False) di pandas?
Kunci jawaban singkat: (1) SELECT kota, COUNT(*) AS jumlah_pesanan, SUM(total) AS total_penjualan FROM pesanan GROUP BY kota HAVING SUM(total) > 150000; menghasilkan Sragen dengan 2 pesanan dan total 245000, serta Yogyakarta dengan 1 pesanan dan total 210000. Solo tersisih karena totalnya 125000. (2) Alias t dibuat di SELECT, yang diproses setelah HAVING, sehingga belum dikenal. Tulis ulang menjadi HAVING SUM(total) > 150000. (3) Pada bentuk default, kota menjadi index DataFrame. Dengan as_index=False, kota tetap menjadi kolom biasa, seperti pada hasil SQL (pandas development team, n.d.).
Ringkasan
GROUP BY mengubah baris menjadi kelompok, fungsi agregat meringkas tiap kelompok, dan HAVING menyaring kelompok itu setelah angkanya dihitung. Pegang satu aturan sederhana: kondisi pada baris masuk ke WHERE, kondisi pada hasil agregat masuk ke HAVING. Besok, pada Hari 13, saya lanjut ke JOIN, cara menggabungkan dua tabel dengan jenis inner, left, right, dan full, yang dijadwalkan terbit 23 November 2026 pukul 09.00 WIB.
Sumber bacaan
DataCamp. (n.d.). PostgreSQL HAVING. https://www.datacamp.com/doc/postgresql/having
PostgreSQL Global Development Group. (n.d.). 7.2. Table expressions. PostgreSQL documentation. https://www.postgresql.org/docs/9/queries-table-expressions.html
pandas development team. (n.d.). pandas.DataFrame.groupby. pandas documentation. https://pandas.pydata.org/docs/reference/api/pandas.DataFrame.groupby.html
Catatan data: seluruh angka pada tulisan ini berasal dari data sintetis yang saya buat sendiri. Tidak ada data pasien atau data pribadi nyata di dalamnya.
Navigasi seri Belajar Analisis Data
- Berikutnya: Hari 13, SQL: JOIN (inner, left, right, full) (terbit 23 November 2026 pukul 09.00 WIB)
- Semua tulisan seri Belajar Analisis Data
- Sebelumnya: Hari 11, SQL Dasar: SELECT, WHERE, ORDER BY, dan LIMIT
Tinggalkan Balasan